项目背景
这个项目参加的是 ModelEngine 社区的开源贡献赛。社区的 AgentsHub 仓库基于 Nexent 平台打造智能体共享生态,收录通用场景和行业垂直场景的智能体。我不想只提交一个对话机器人,而是想验证一条完整的工程链路:把医疗示例数据从原始 CSV 和非结构化文本,加工成结构化数据、知识图谱,再向上支撑问答与分析。
选择医疗示例数据是因为它天然混合了两种数据形态:结构化的病历记录表和非结构化的症状描述文本。数据形态差异会放大真实的工程问题——清洗规则怎么兼容两类输入、抽取结果怎么落到统一的图谱结构、下游问答和分析又依赖哪些前置产物。这些问题比单点功能更接近实际生产环境。
总体架构与任务拆分
整个 Demo 按”数据 → 知识 → 洞察”拆成三个任务,外加两个横向层:
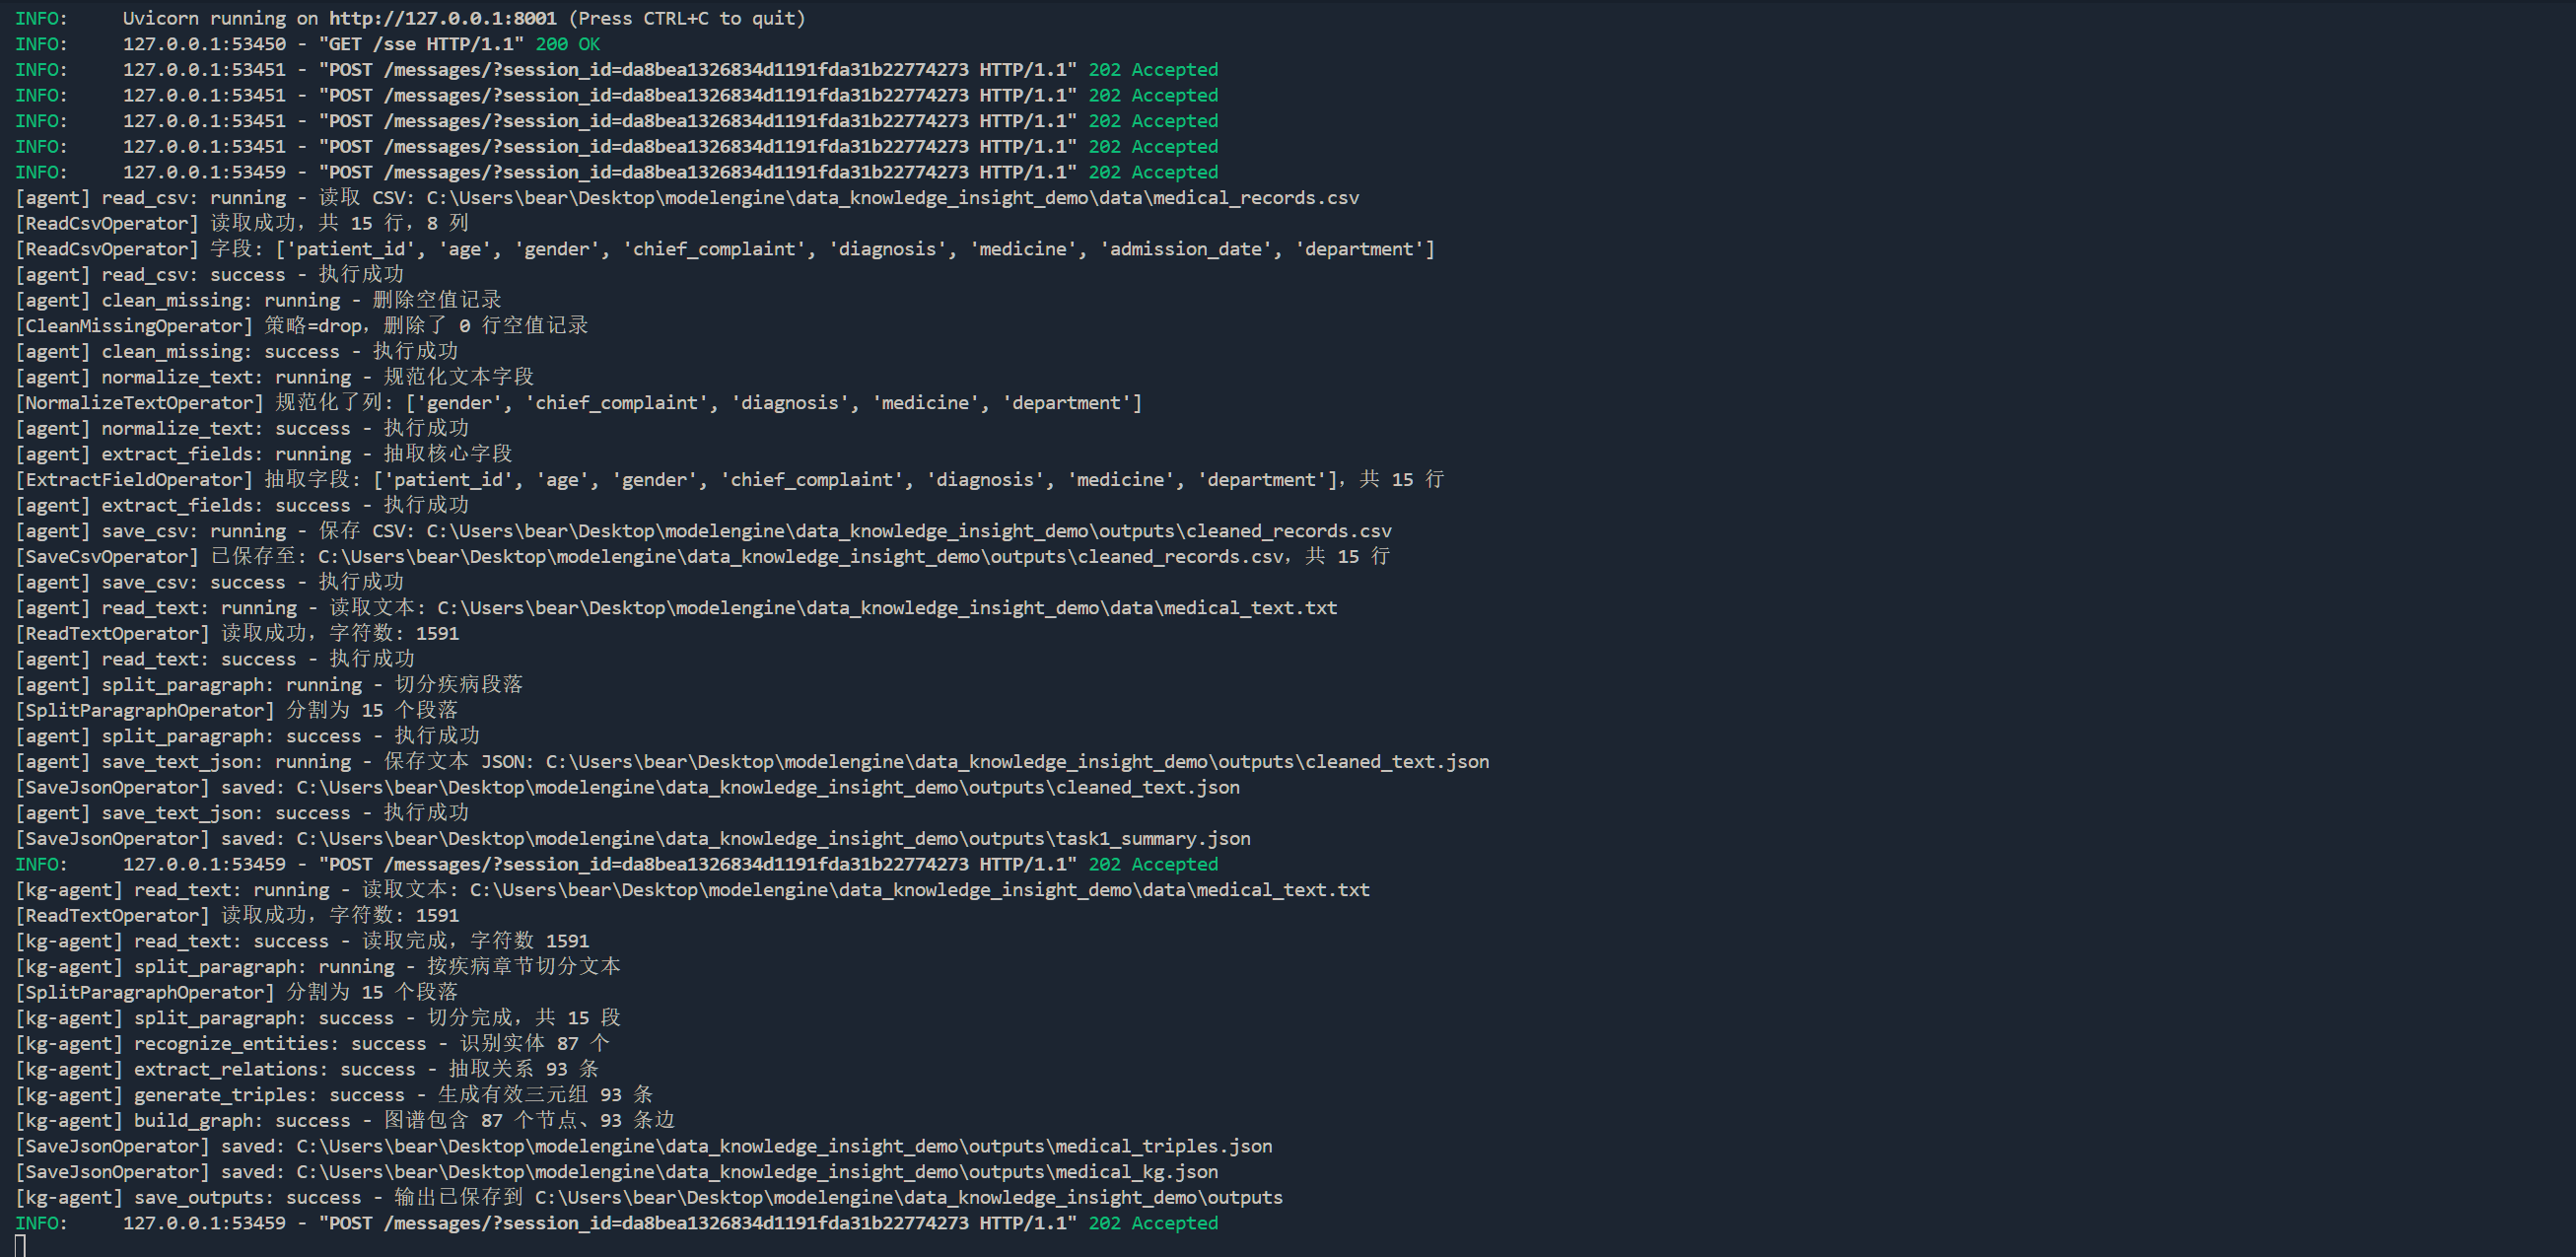 图:Data Knowledge Insight Demo 总览
- 任务一(数据处理):清洗 CSV、规范化文本、抽取核心字段;
- 任务二(知识构建):实体识别、关系抽取、三元组生成与校验;
- 任务三(数据分析):图谱统计、中心性分析、SQLite 构建、NL2SQL 模板评估与图表输出;
- planners 层:RuleBasedTaskPlanner 把自然语言任务描述映射成执行计划,LLMTaskPlanner 作为增强路径;
- adapters 层:DataMate 风格 mapper 与 Nexent/FastMCP 风格工具,负责向真实平台迁移。
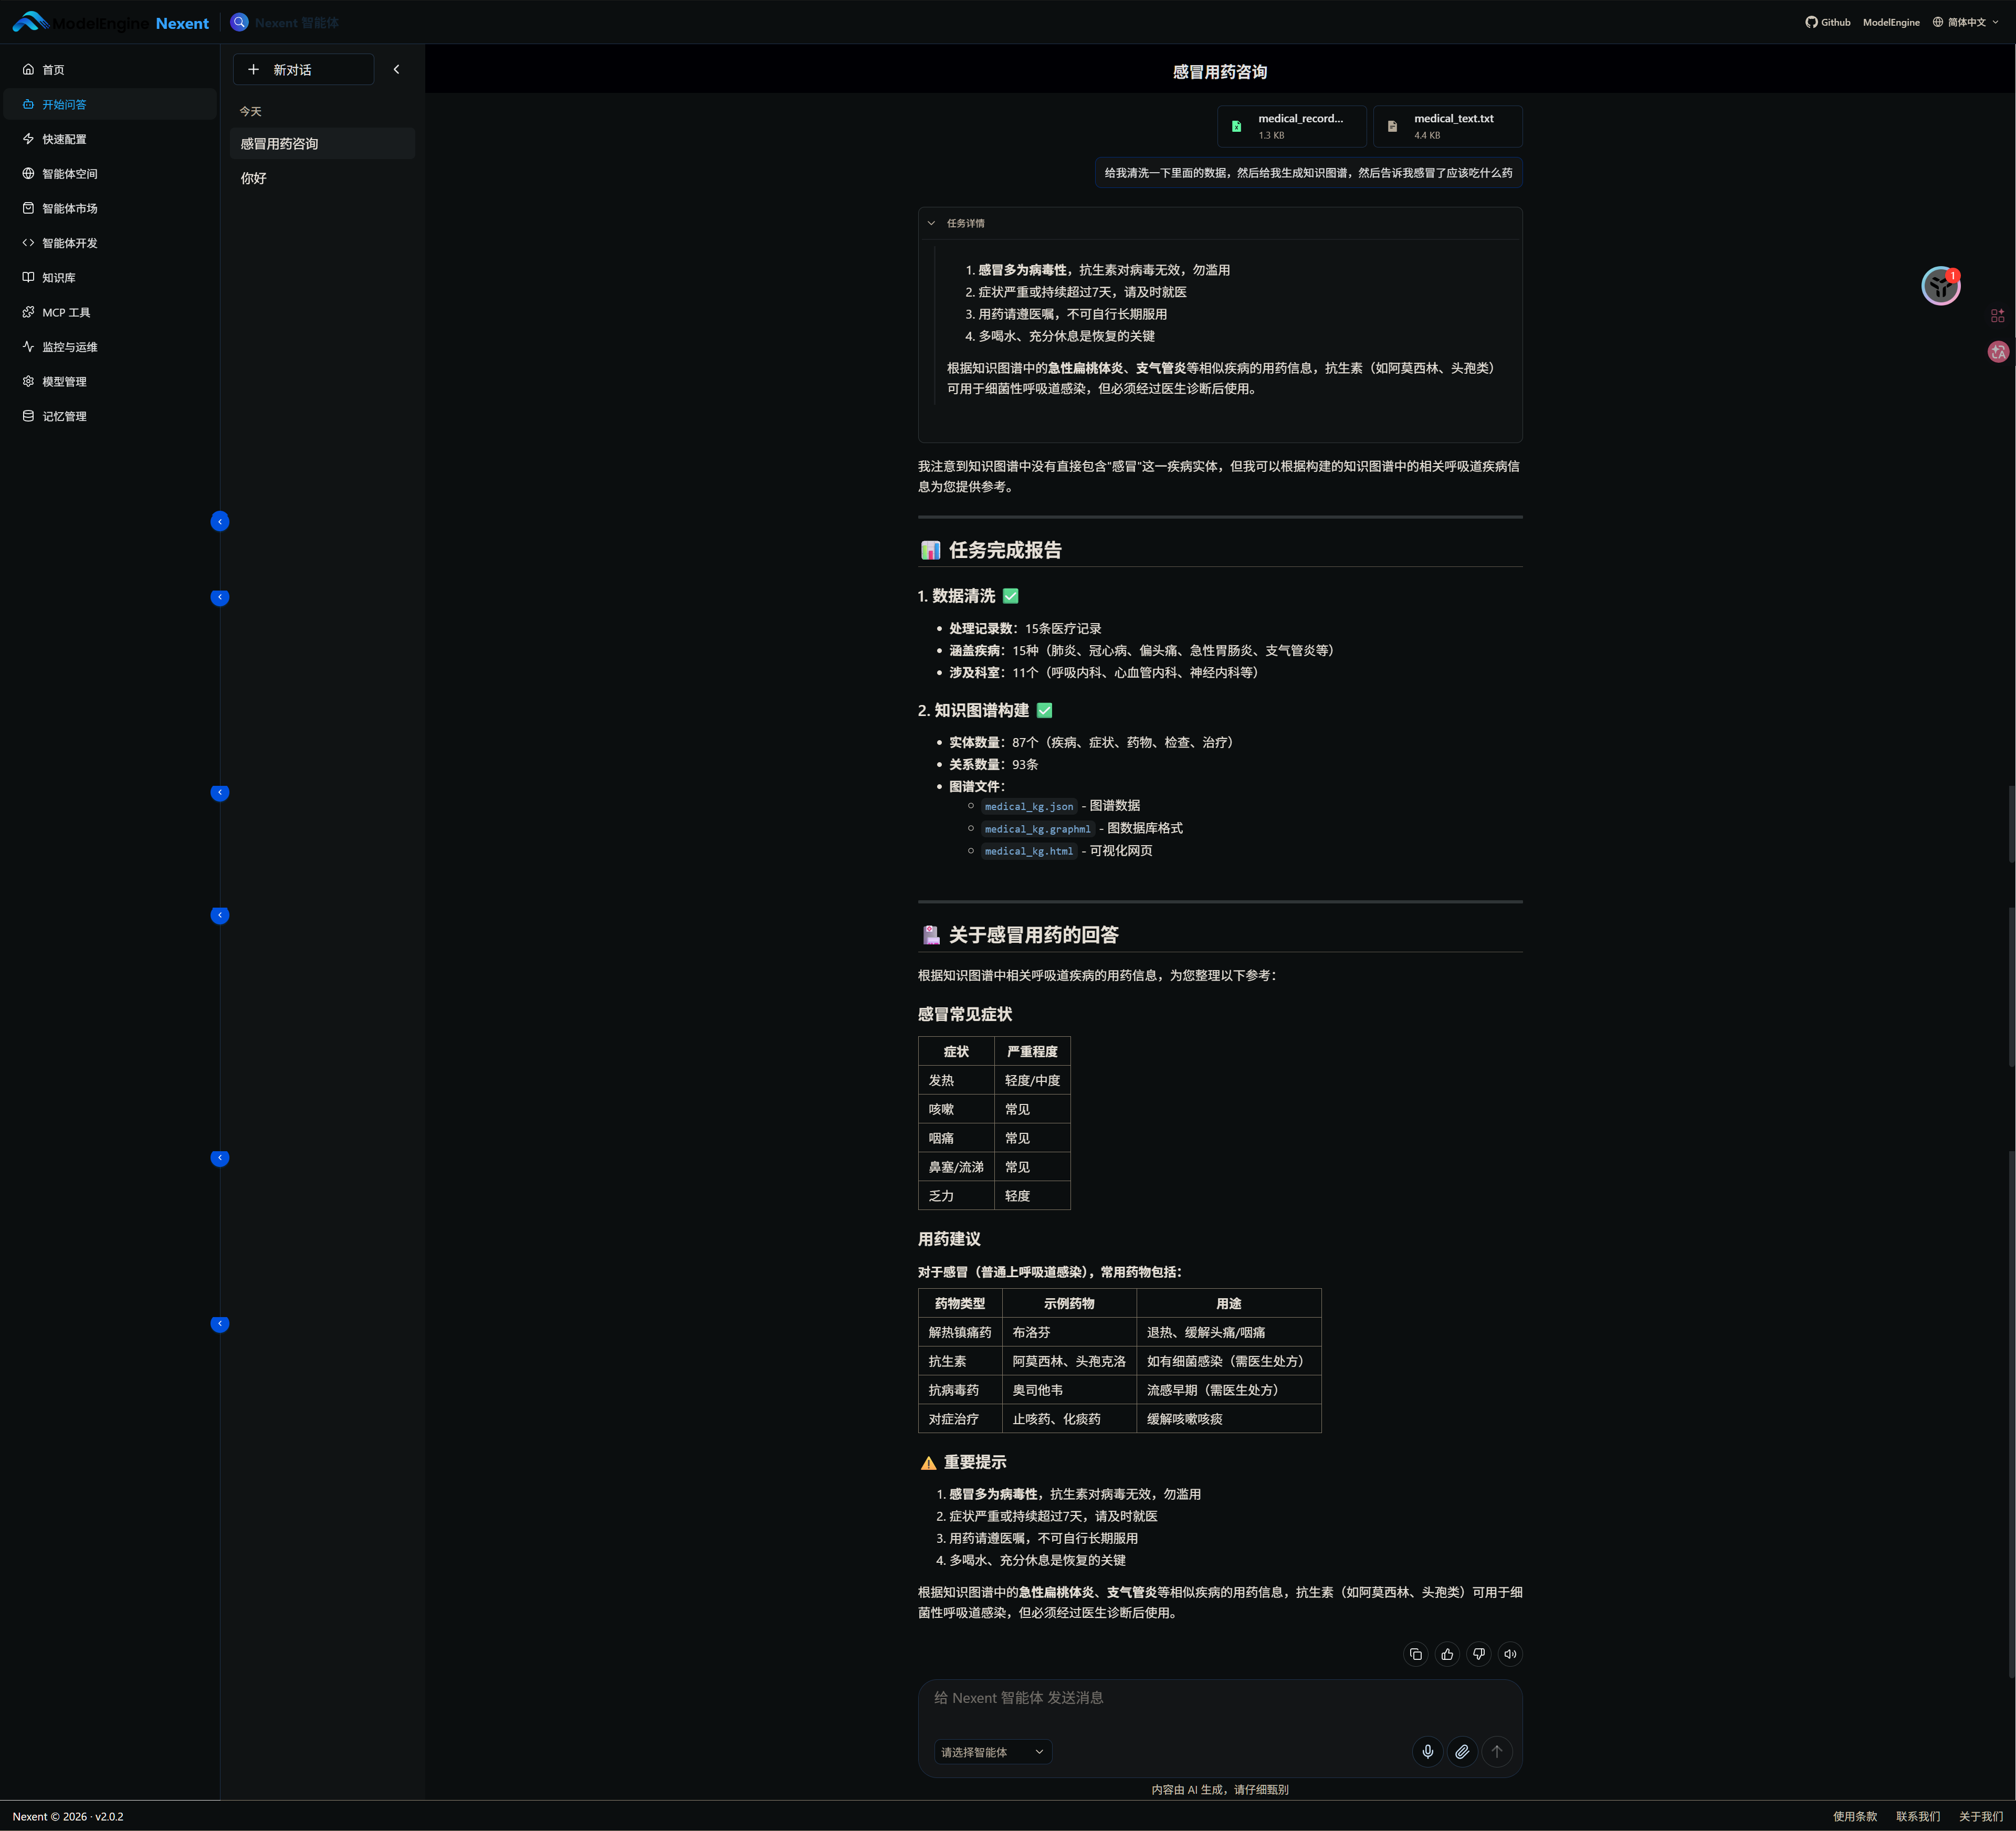 图:从原始数据到洞察产出的完整流程
这样拆的好处是每个任务的输入输出都是明确的产品:任务一产出干净数据,任务二产出图谱文件,任务三产出报告和图表。任何一环出问题都能定位到具体边界,而不是在一个大函数里排查。
数据处理智能体
任务一要同时吃下两种输入。CSV 侧做缺失值清洗、文本字段规范化和核心字段抽取;文本侧做读取、切分和结构化导出。执行计划由规则规划器生成:“只处理 CSV""只处理文本""两者都处理”分别映射成不同的步骤序列。
LLMTaskPlanner 是这条链路上的增强项:让真实模型根据任务描述生成计划。但模型输出不可信时必须有兜底——返回坏 JSON 或未知步骤时自动回退到规则规划结果。此外每个步骤可以通过 StepExecutionPolicy 单独配置重试、必选或可跳过行为,失败时汇总进 execution_state.errors 而不是中断整条流水线。
这套设计的出发点很简单:规划可以智能,执行必须可靠。
知识图谱构建与问答
任务二从医疗文本里抽取疾病、症状、药物等实体及其关系,生成三元组并做校验,然后导出三种格式:JSON 供程序消费,GraphML 供图分析工具导入,HTML 用 pyvis 直接可视化。
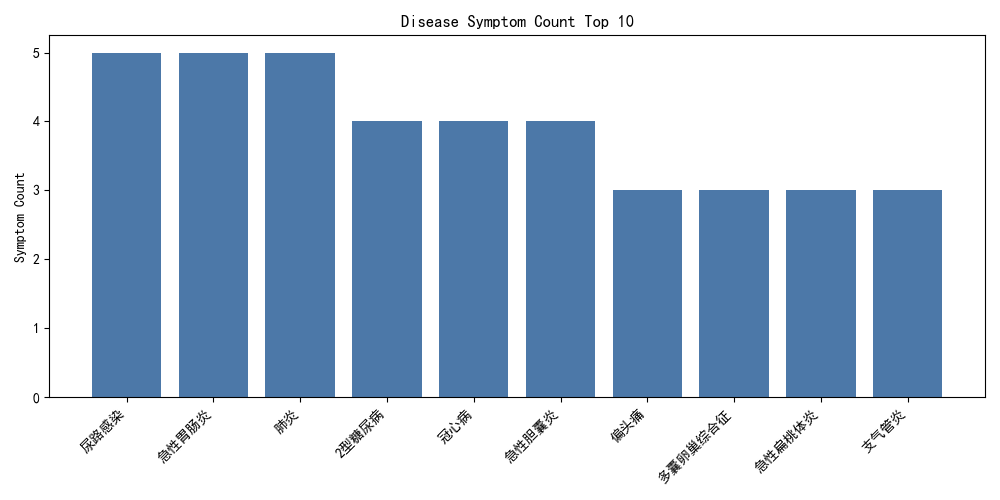 图:知识图谱中疾病-症状关系统计
图谱之上是 KGQAAgent。它支持四类问法:疾病查症状、疾病查用药、症状反查疾病、药物反查疾病。问答直接落在图结构上,答案附带证据路径,避免了生成式模型自由发挥带来的不可解释性——医疗场景里这一点尤其重要。
数据分析与 NL2SQL
任务三把图谱和清洗后的数据进一步变成洞察:节点边数与实体类型统计、疾病症状数量、药物关联疾病数量、中心性分析,并用 matplotlib 输出图表。清洗后的记录写入 SQLite 后,再用 NL2SQL 模板评估自然语言到 SQL 查询的转换效果。
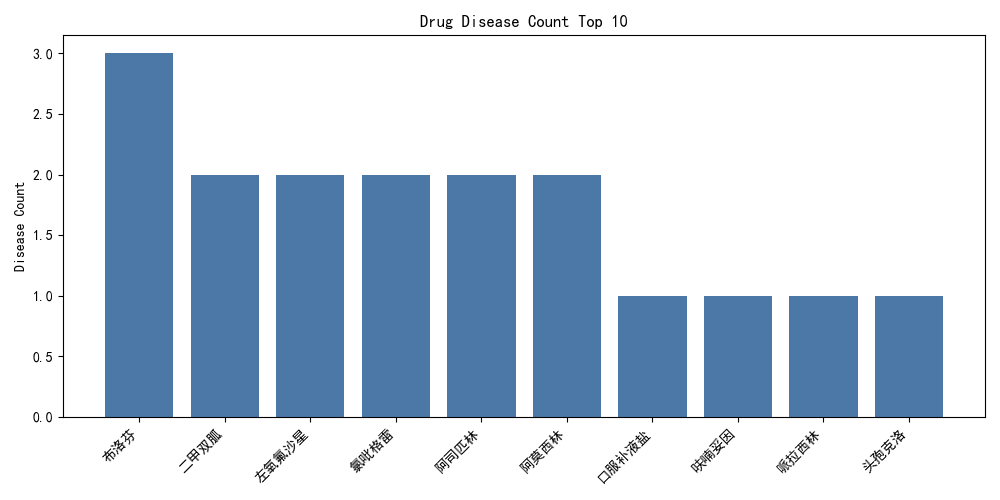 图:药物-疾病关联统计
NL2SQL 这一步我没有追求自由文本到任意 SQL 的转换,而是先用模板圈定可回答的问题域。模板评估的意义在于先建立可衡量的基线,再谈扩展。
平台集成:DataMate 与 Nexent
这部分回答一个关键问题:Demo 怎么迁移到真实平台。
DataMate 侧,我把清洗逻辑改写成 sample -> sample 风格的 mapper(CleanTextDataMateMapper、NormalizeMedicalRecordMapper 等),并提供 datamate_task1_package 目录作为可直接搬运的包示例。迁移成本从”重写”降到”对照结构搬移”。
Nexent 侧,用 FastMCP 把四个业务能力封装成远程 MCP 工具:process_medical_data、build_medical_knowledge_graph、ask_medical_kg、analyze_medical_data。工具内置前置产物检查——图谱文件不存在时返回结构化的 missing_prerequisite 提示而不是崩溃。
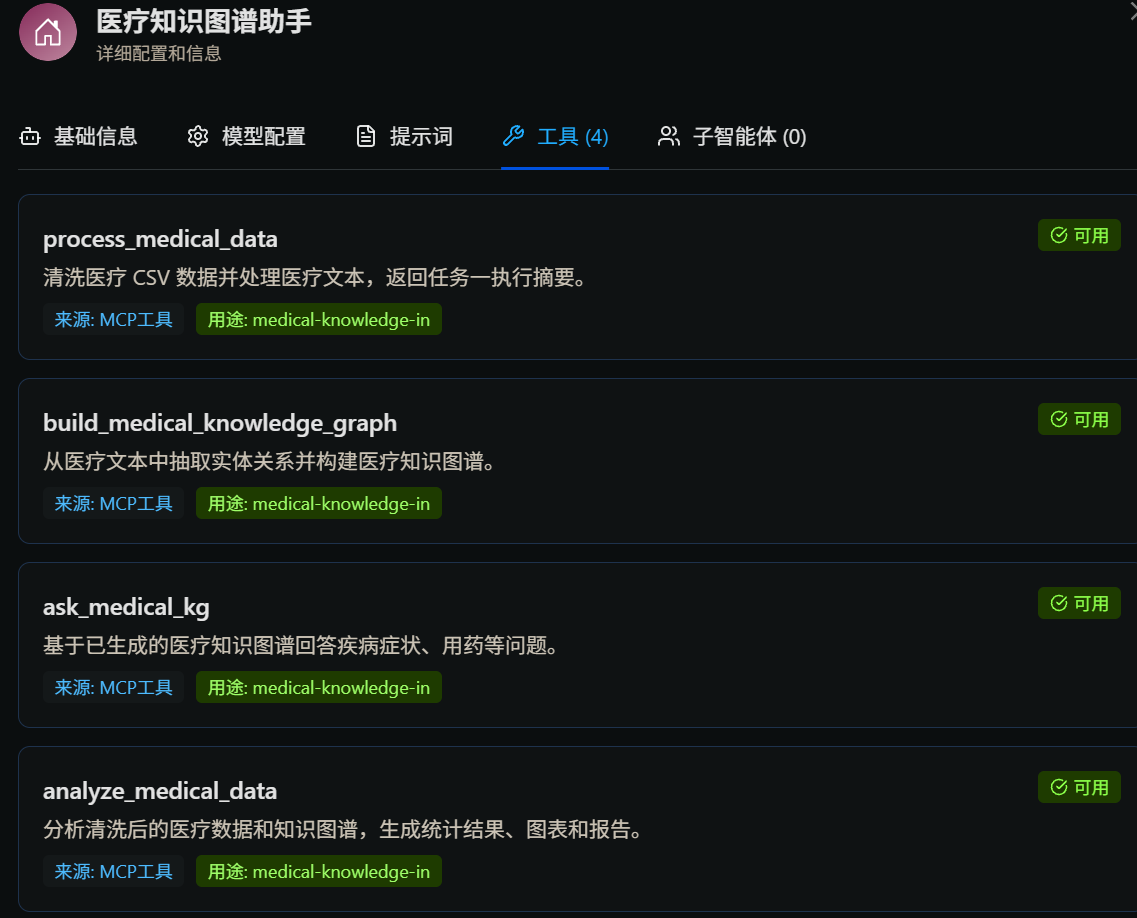 图:在 Nexent 中配置 MCP Server
我在本地用 Docker 跑通了这个集成:Nexent 容器内通过 host.docker.internal 访问宿主机 8001 端口的 MCP Server,界面上创建医疗智能体并勾选四个工具后,可以直接用自然语言触发数据处理、图谱构建、问答和分析。
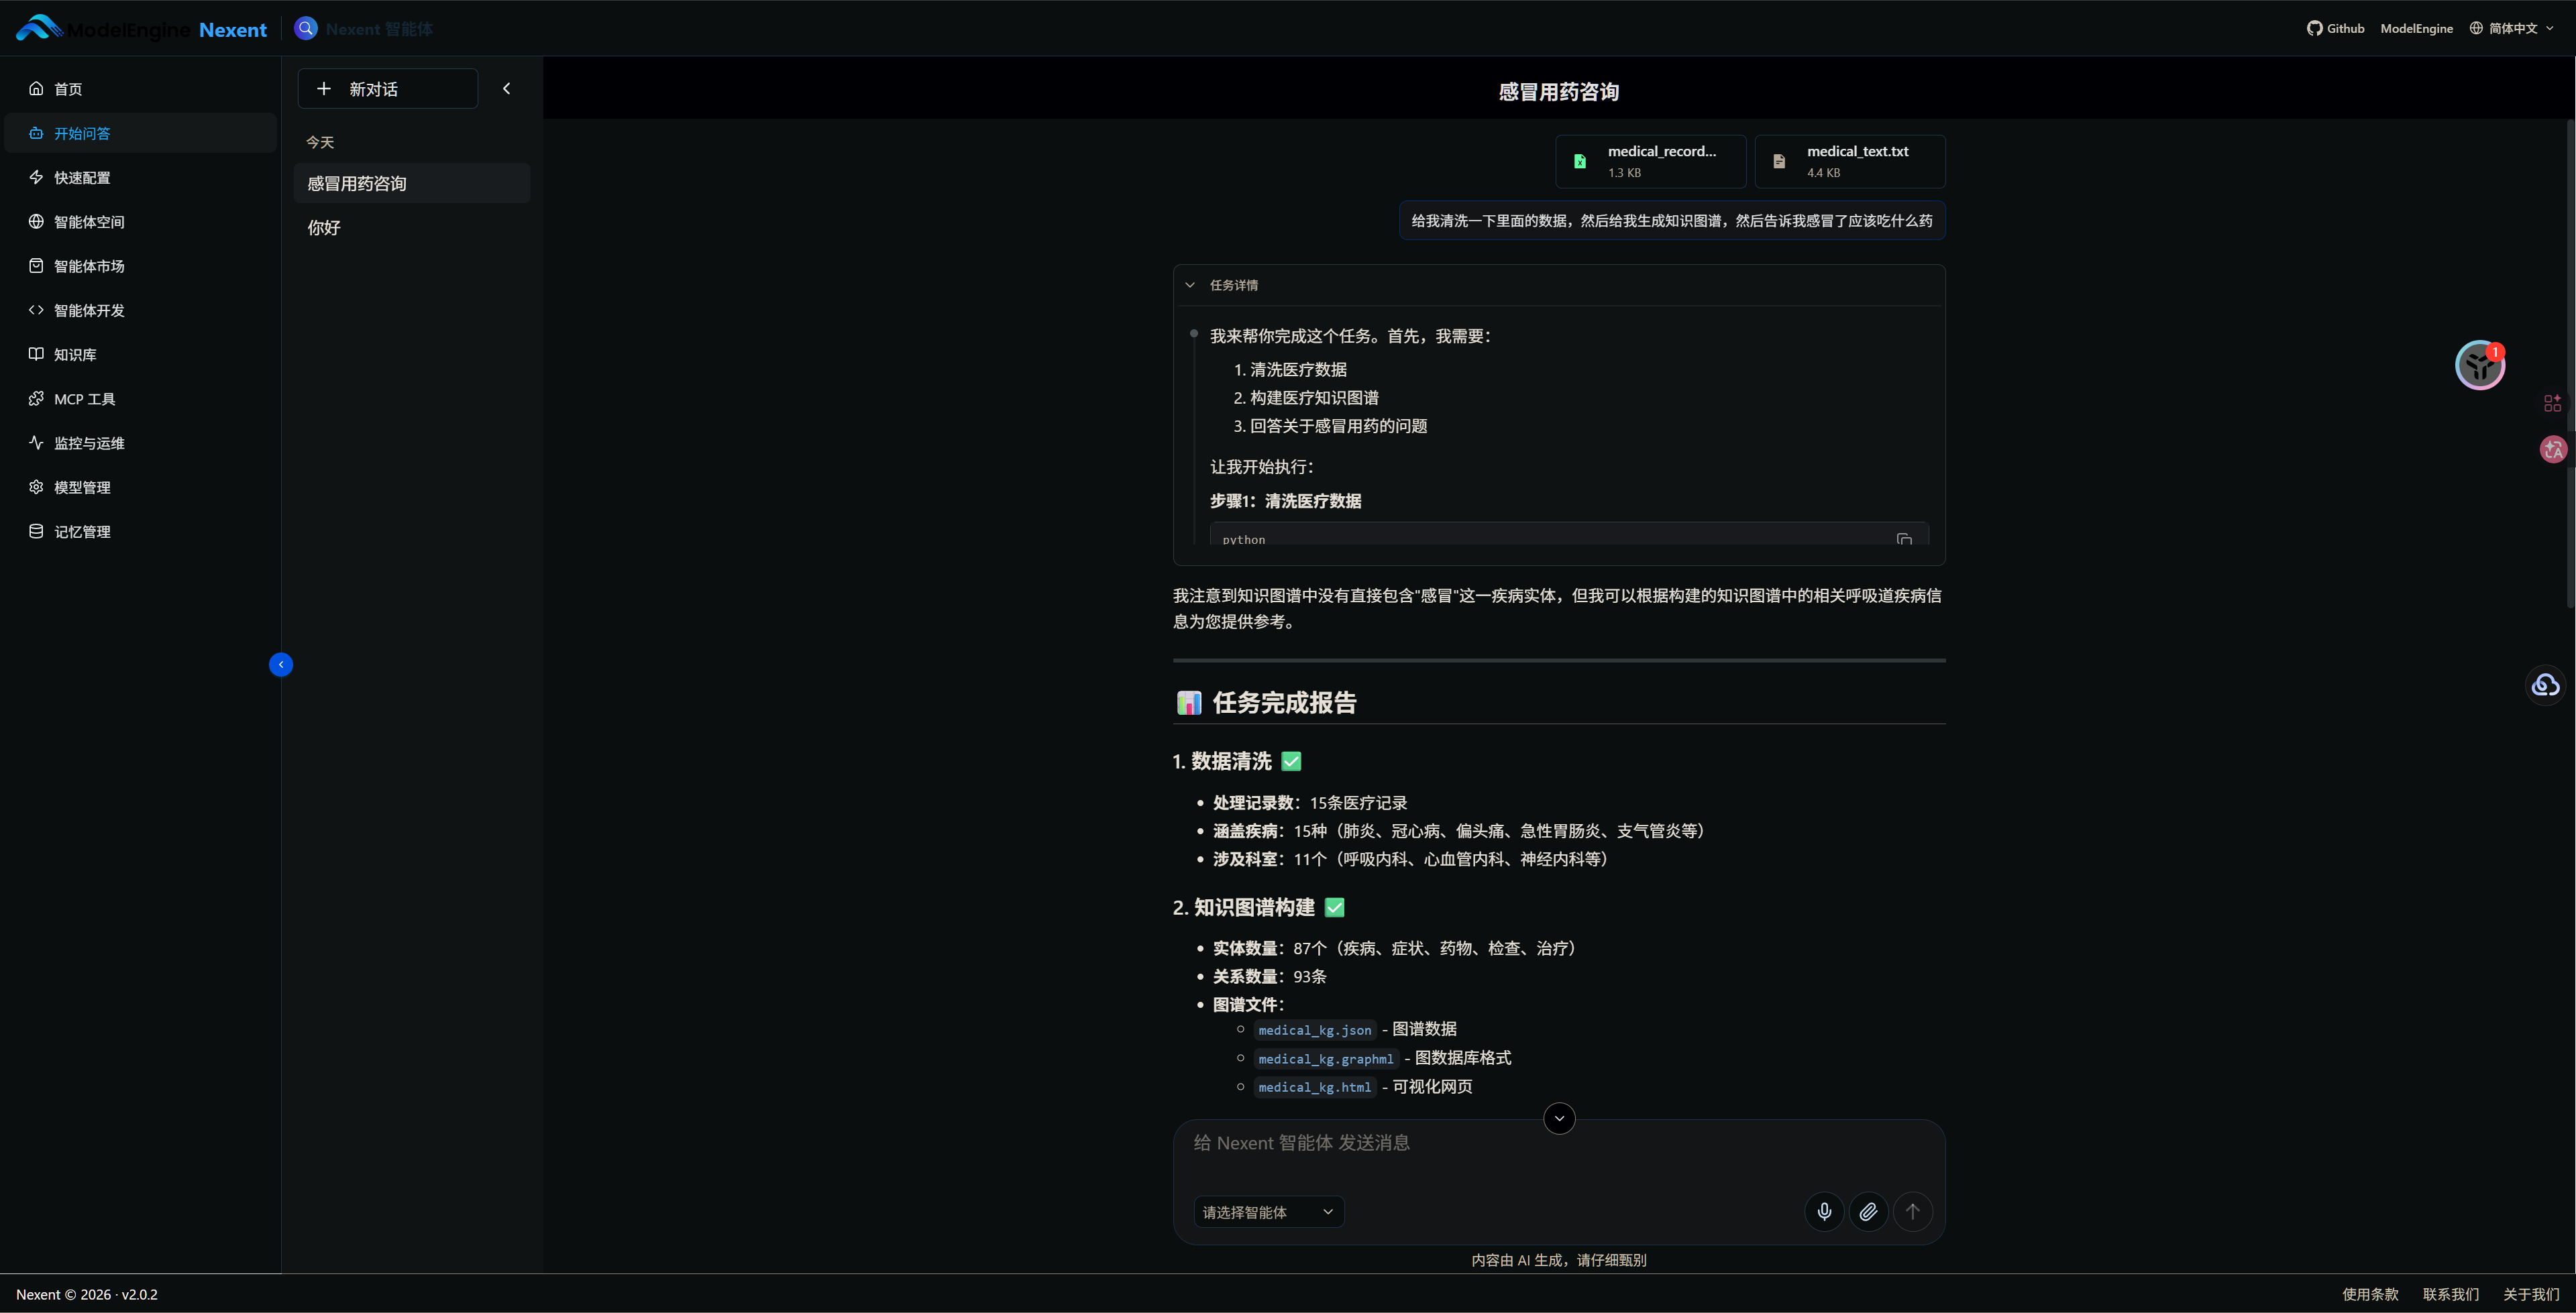 图:Nexent 中的医疗知识图谱助手
结果与复盘思考
最终交付是一个可一键运行、可测试、可解释的闭环:run_demo.py 依次跑通三个任务,FastAPI 暴露健康检查与三大任务共五个接口,56 个 pytest 测试全部通过。项目获得 ModelEngine 开源项目贡献赛三等奖,代码合入社区 AgentsHub 仓库。
复盘下来有三点值得沉淀:
第一,先保证端到端可运行,再谈单点优化。三个任务各自做到 MVP 后立刻串成闭环,很多接口设计和产物格式问题是串起来之后才暴露的。
第二,规划可以有弹性,执行必须有兜底。LLM 参与规划提升了灵活性,但真正让系统可靠的是回退机制和每一步的策略配置。
第三,适配层值得提前设计。adapters 独立成模块后,向 DataMate 和 Nexent 的迁移变成了结构对照和搬移,而不是侵入式改造——这也是它能进入社区共享生态的直接原因。